2026 年底的 AI 開發者生態正經歷著一場奇妙的轉變:一邊是各大雲端巨頭(Anthropic、Google、OpenAI)不斷升級的訂閱價格、階梯式算力額度限制以及嚴苛的帳號風控;另一邊是開源大模型與推理框架的野蠻生長。當身邊的朋友紛紛遭遇 Claude 訂閱到期、封號危機或算力焦慮時,一個經典的念頭再次浮上心頭:「我們能不能完全依靠本地消費級硬體,跑起真正具備 Agent 編程實戰能力的超大模型?」
過去,本地部署 100B+ 參數的模型往往意味著遙不可及的多卡服務器集群(如雙卡 A100/H100)。然而,Strata 框架橫空出世,其核心目標直指打破顯存壁壘:利用當前 MoE 架構「單次推理僅激活少數專家」的稀疏特性,將活躍專家緩存在顯存(VRAM),非活躍專家保留在高速系統記憶體(RAM)中,藉由 PCIe Gen5 的恐怖帶寬進行即時置換。其作者甚至公開宣稱要讓普通家庭硬體以 30~35 tok/s 跑動 700B 規模的 DeepSeek 4.1 Flash。
正好 Y CHEUNG 手頭的主機配了 32GB 顯存的 RTX 5090 和 128GB DDR5 記憶體,硬體條件踩在門檻上。於是花了一整個週末,把安裝、配置、客戶端接入和實際寫代碼跑了一遍,下面是真實的記錄與踩坑整理。
一、 測試平台與環境設定 #
工欲善其事,必先利其器。運行參數量超過 100B 的 MoE 模型,除了強勁的 GPU 算力外,顯存容量、系統記憶體帶寬以及 PCIe 傳輸速率才是真正的決定性瓶頸。
1.1 硬體規格配置 #
| 硬體組件 | 規格參數 |
|---|---|
| 作業系統 | Windows 11 Pro 64-bit |
| 處理器 (CPU) | Intel Core Ultra 9 285K (24 核心 / 24 線程) |
| 顯卡 (GPU) | NVIDIA GeForce RTX 5090 (32GB GDDR7) |
| 記憶體 (RAM) | 128 GB DDR5 (4800 MHz) |
| 固態硬碟 (SSD) | Crucial T705 4TB PCIe 5.0 NVMe SSD |
1.2 部署模型選擇 #
在 Strata 框架中,Y CHEUNG 選用了社群目前調校最成熟的旗艦級 MoE 模型:
- 模型名稱:
qwen3.8-flash-next-iq3_s(總參數量約 125B 的 MoE 架構) - 量化技術:採用了 GSQ-RCO(Grouped Split Quantization with Residual Calibration Optimization)技術進行 3-bit 壓縮,在控制顯存與記憶體體積的同時,盡可能保證邏輯與代碼生成的精度。
- 上下文窗口 (Context Window):初次設為 128K,後續修改配置提升至原生的 256K。
二、 安裝實戰與踩坑全記錄 #
2.1 坑位一:不要跳過模型下載 #
Strata 官方文件提供了讓 AI Agent 執行的安裝腳本指引。Y CHEUNG 一開始圖省事,直接將文檔丟給 Agent 執行安裝。在交互流程中,安裝程式詢問:
“Do you want to download the model now?”
出於對動輒幾十上百 GB 模型體積的敬畏,Y CHEUNG 下意識地選擇了「否」,打算先看看核心服務能否乾淨啟動。結果證明這是個致命誤區:Strata 的 Engine 啟動完全依賴已就緒的模型權重進行 GGUF 矩陣轉化與架構綁定。缺少模型,後續的 CLI 向導將直接拋出空指針與中斷退出。
解決方法:老老實實讓向導下載完整模型,不要跳過。
2.2 坑位二:8080 端口衝突 #
手動重跑 strata launch 向導,依次選擇模型、下載目錄與 128K 上下文後,終端在「Starting the engine and loading the model」階段突然爆出紅字:
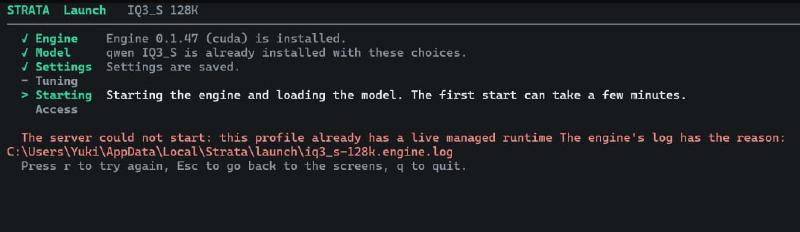
更令人抓狂的是,當 Y CHEUNG 前往上述路徑尋找原因時,發現目錄下根本沒有生成該 .log 文件,只有一個靜態的 .json 配置文件!
經過排查後發現,罪魁禍首是端口被佔用。Strata 本地服務默認監聽 http://127.0.0.1:8080。而 Y CHEUNG 日常後台運行著 Docker 容器(內部映射了資料庫到本機 8080 端口),同時後台還有 Ollama 殘留進程。Strata 在綁定端口失敗時,進程意外崩潰,導致其向導認為前一個 runtime 還在「存活」狀態,陷入死鎖。
解決方案:
- 關閉所有佔用 8080 的服務(徹底退出 Docker 與 Ollama 守護進程)。
- 在 Windows 下重啟電腦,清除殘留的進程死鎖與暫存具柄。
- 重新執行
strata launch。
2.3 自動校準(Tuning Phase)與基準測試 #
重啟後再次執行,Strata 順利進入了 硬體調優基準階段(Tuning),當然這部分也是可以跳過的。
在 Tuning中系統會針對當前機器的 CPU、GPU 與內存延遲,進行 7 輪嚴密的實時吞吐量測試,以評估在不同上下文長度下的 Prompt 處理速度:
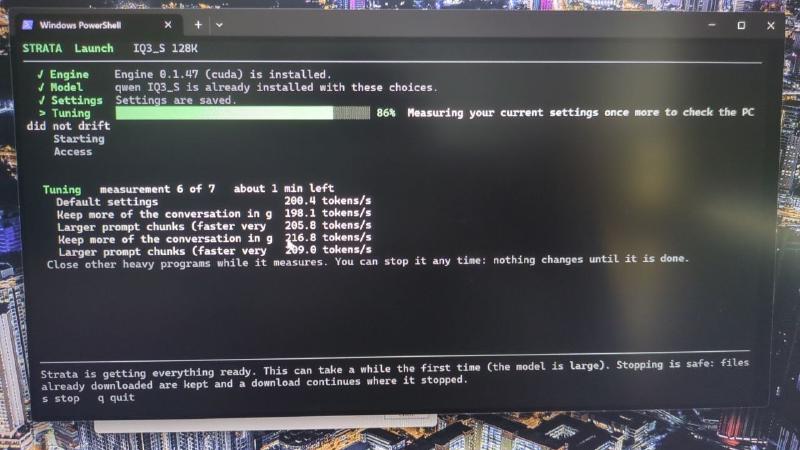
實測顯示,在 RTX 5090 上,strata (v0.2.2) 的調優吞吐穩定在 200 ~ 216.8 tok/s。測試跑完後,Strata 順利啓動,終端顯示了 TUI 監控面板。
三、 Strata 終端面板與運作數據 #
Strata 內建的 TUI 面板設計得很清晰,可以直觀看到專家分佈與各硬體負載:
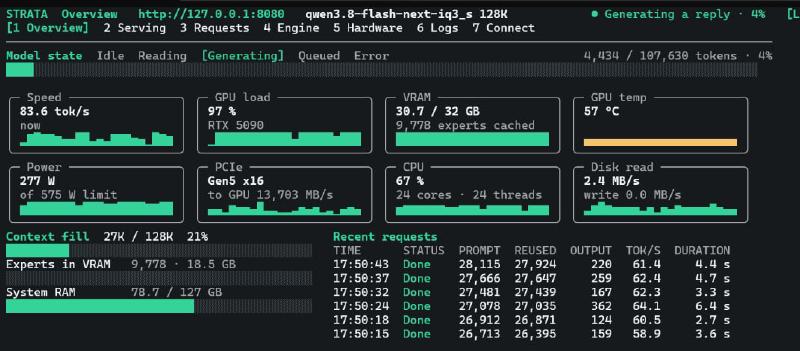
從實時數據可以看出它的運作機制:
- 顯存吃滿:32GB 顯存佔用了 30.7GB,其中緩存了約 9,778 ~ 10,101 個專家權重(約 18.5 ~ 19.2 GB),其餘留給上下文與激活層。
- 記憶體當二級緩存:系統 128GB 記憶體被吃掉了近 80GB(峰值接近 90GB),其餘未激活的專家權重全部放在這裡。
- PCIe 傳輸速率極高:生成時 PCIe 傳輸速率頻繁在 13,700 MB/s 到 22,300 MB/s 之間跳動,相當於每秒在記憶體和顯存間搬運十幾到二十多 GB 的資料。
- 生成速度:解碼階段約 60 ~ 83 tok/s。
四、 客戶端體驗與對比 #
Strata 底層提供相容 OpenAI 與 Anthropic Messages 格式的接口(http://127.0.0.1:8080/v1)。Y CHEUNG 前後測試了三種接入方式:
4.1 方案 A:Strata 官方桌面端(不建議使用) #
Strata 官方提供了一個封裝好的桌面應用 (Strata-0.2.2-windows-cuda13.exe ,聲稱能實現開箱即用的沉浸式體驗。
- 資源佔用與流暢度:啟動時後台會拉起一套 Node.js 和 Python 運行環境,介面操作略顯遲緩;
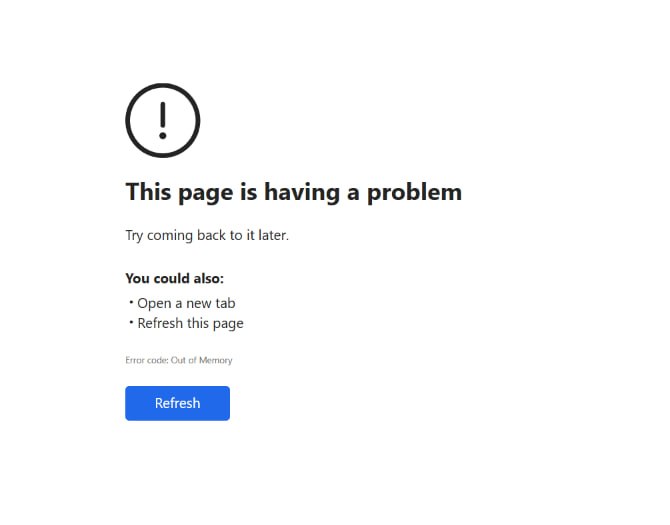
- 長對話容易遇到內存壓力:在對話長度拉長或持續運行一段時間後,容易出現卡頓甚至白屏,實測中途還遇到過一次瀏覽器內核的
Out of Memory崩潰,整體穩定性在長時間連續使用時仍有優化空間。
4.2 方案 B:獨立版 DeepSeek Harness (上下文膨脹與繁重機制) #
在朋友 Dante 的推薦下, Y CHEUNG 轉向了原版的 DeepSeek Harness(DSH)。DSH 的設計哲學是「一切皆插件」,核心 Agent 循環本身也是個可替換插件。
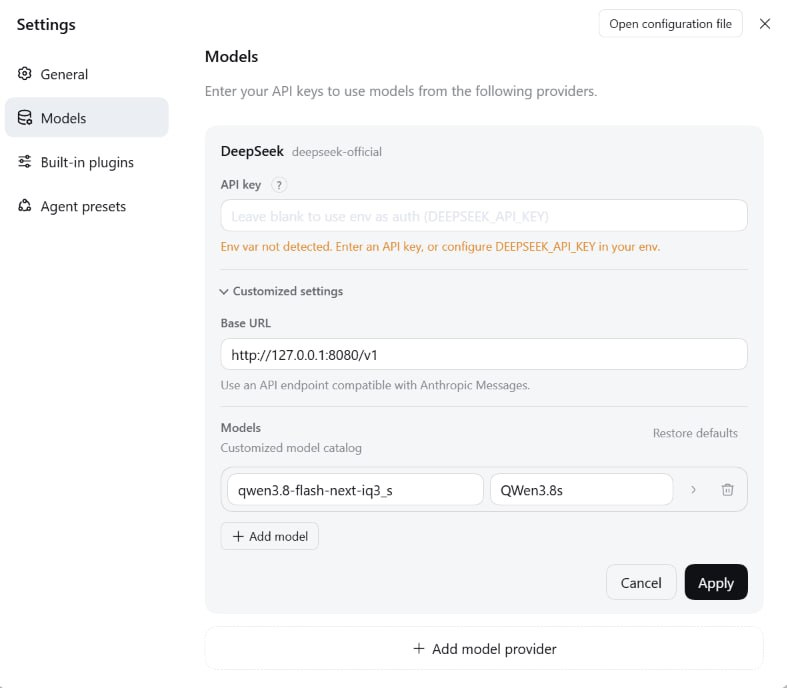
- 必填 API Key:雖然 Strata 本地端點沒有嚴格驗證 key,但 DSH 的介面如果不填 key 就無法保存配置,最後Y CHEUNG 從另一個工具(OpenCode)的配置文件中複製了一段標準格式的假 Key(
sk-xxx)填入,才順利通過驗證; - 工具鏈割裂與權限受限:模型在啟動規劃時抱怨:
這個 session 未啟用 plan mode,我直接將完整開發計劃寫成專案文件交付,當需要使用外部資訊時提示:唯一待補資訊:網路搜尋工具目前不可用(API key 失效),需要使用者自行配置 Google/Bing Search API Key 等; - 輸出偶發異常字符:在生成時文字偶爾會蹦出一些奇怪的斷詞(如「雨個字符」之類的字符解碼問題);
- 提示詞過於龐大:DSH 默認的 Agent Preset 塞了大量系統約束與插件定義,使用者一句話發過去,模型實際接收的上下文有時直接衝到 50,000+ tokens。預設的 128K 上下文在兩三輪對話後直接撞牆(
Output token limit reached)。為此, Y CHEUNG 不得不手動修改 Strata 的 JSON 設定檔,將上下文強行擴展到 256K; - 黑話 Subagent 與時間黑洞:在多 Agent 協同模式下,模型 Agent 開始自動分發多個子任務,給子代理起了令人啼笑皆非的工程師職稱「領域規則工程師」、「專案執行器工程師」、「決策管線工程師」。四個子代理同時在後台互問互答,累計跑了 8.2M tokens,耗時 73 分鐘,但核心功能進度依然停滯不前;
- 沙箱限制過嚴:DSH 調用本地環境工具時缺乏可視化配置,模型嘗試訪問外部網絡(HTTPS 443 端口)失敗。
4.3 方案 C:Claude Code CLI(目前最合適的本地搭配) #
在經歷了桌面端白屏與 DSH 的無效內耗後, Y CHEUNG 回到了最熟悉的 CLI 陣地:Claude Code CLI。
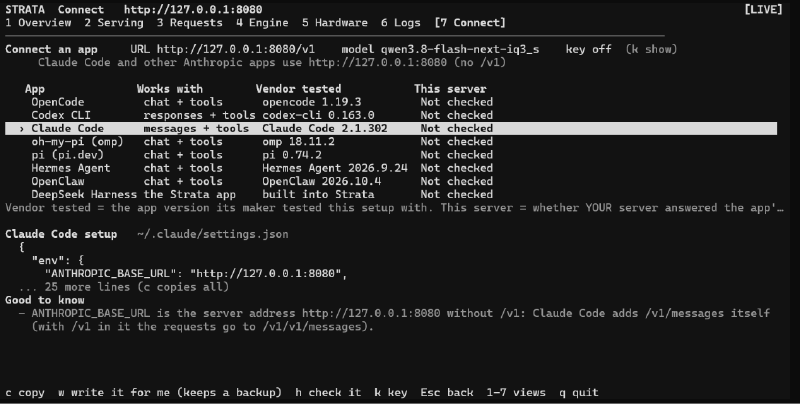
切到 Strata TUI 的 7 Connect 面板,直接複製裡面針對 Claude Code 給出的一長串環境配置,貼進 .claude/settings.json 的 env 欄位中完成設置。
- 系統不再有介面卡頓或白屏問題;
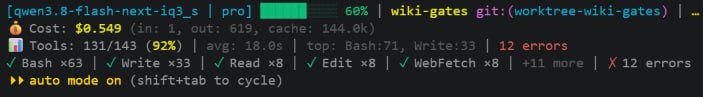
- Prompt Caching 生效明顯:在 256K 上下文下,單次請求 13 萬 tokens,其中有 12 萬 tokens 成功命中緩存(Reused),大幅緩解了預處理延遲。
- 工具調用表現:累計 143 次工具調用中成功了 131 次(成功率 92%),平均每次工具執行耗時約 18 秒。
五、 本地開源模型 vs 雲端模型:實際差距在哪裡? #
連續高強度使用了幾天後,一些很實際的落差體現得非常明顯:
5.1 速度與延遲:Prefill vs. Generating #
雖然 TUI 面板上顯示生成速度有 60~80 tok/s,打字機效果看起來挺快,但在實際 Agent 工作流中:
- 預處理階段(Prefill):本機 Reading 速度約為 8,000 ~ 10,000 tok/s。當對話積累到 10 萬 Token 以上時,即使有 Prompt Cache,每次發送請求後依然需要等待數秒至十幾秒的模型「沉思時間」;一旦緩存未命中,等待時間將直接突破半分鐘。
- 工具鏈調用耗時:在 Agent 工作流中,頻繁的「思考 -> 調用 Bash -> 讀取輸出 -> 再思考」循環,導致平均單個工具執行週期長達 18 秒。相較於雲端頂級模型(通常 2~4 秒完成一次 Tool Use),整體開發節奏明顯被拖慢。
5.2 功耗與硬體代價 #
本地運行的「免費」並非沒有代價:
- 電量狂飆:在 Strata 全負載解碼與專家置換期間,RTX 5090 功耗穩定在 200W~280W,在複雜並發下實測瞬時功耗高達 407 W(顯卡 TGP 上限 575W)。
- 發熱與噪音:GPU 核心溫度維持在 57°C 左右,機箱風扇全程高轉速咆哮。
- 系統資源佔滿:128GB 記憶體被吞噬了近 90GB,日常使用的瀏覽器標籤頁甚至頻繁被系統壓縮或釋放。
5.3 代碼能力與邏輯深度的差距 #
這也是整場測試中最直接的體會:模型參數量的物理限制與調校深度,依然是難以逾越的鴻溝。
在 Y CHEUNG 新建立的專案中,遇到了一個難以捉摸的 Bug。Agent 始終提示找不到指定路徑,宣告在遊戲 runtime 中該模組不存在。Y CHEUNG 讓本地 Qwen 模型排查了 2 天,它反覆嘗試了幾十次修改,提出各種天馬行空的「架構重構」,卻始終沒有找到問題本質。 第二天下午,Y CHEUNG 實在受不了,重新安裝了 Google 的 Antigravity 應用:
- 規劃階段:交給 Claude Opus 5.5 (Medium) 進行全局 Code Review 與架構規劃,一口氣拆解出精準的修復步驟。
- 執行階段:在 Claude 額度暫時耗盡後,切換至 Gemini 3.8 Flash (Medium) 執行具體代碼修改與單元測試修復。
結果令人哭笑不得:困擾了本地模型整整兩天的 Bug,Gemini 3.8 Flash 在短短10分鐘內精準定位並修復完畢,一發通關。
六、 折騰總結 #
實驗最終以 Y CHEUNG 與好友 Dante 雙雙「老老實實續費 Claude」畫下了充滿戲劇性的句點,但這並不代表 Strata 沒有價值。
在短短一兩年前,在個人電腦上以 80 tok/s 跑動一個 125B 參數、上下文達到 256K 的 MoE 模型,無異於天方夜譚。Strata 透過極致的專家置換算法與硬體總線利用,將這個未來提前拉到了我們眼前。對於高度重視資料隱私、離線運行環境、或者是處理大量重複性文本分析的任務,本地部署已經具備了強大的實用價值。
但在當下這個節點,如果你需要的是頂級的程式碼重構思維、複雜邏輯推理與高精準度的自主 Agent 決策,那麼**「雲端頂級大腦負責規劃架構 + 快速經濟模型或本地端點負責單點執行」**,依然是性價比最高、也是最不折磨人的黃金搭檔。
6.1 給折騰者的實用建議 (Actionable Tips) #
- 硬體門檻:不要輕信「8GB 顯存暢玩百億 MoE」的宣傳。想要獲得具備實用意義的速度(50+ tok/s),至少需要 16GB VRAM + 64GB RAM(如 RTX 5080/4090);若想衝擊 128K/256K 上下文,32GB VRAM + 128GB RAM + PCIe Gen5 才是舒適線。
- 遠離笨重桌面客戶端:優先選擇輕量化的 CLI 工具(如 Claude Code CLI、Pi CLI 或自研精簡腳本),避開記憶體管理不佳的 Electron 包裝器。
- 主動修剪 Agent Preset:DeepSeek Harness 等預設環境注入了太多冗餘的 System Prompt 與無效限制。如果要用本地模型做 Agent,務必精簡提示詞,只保留最核心的工具描述,把寶貴的上下文空間留給程式碼。
- 警惕端口與死鎖問題:本地服務啟動失敗時,第一時間檢查端口 8080 是否被 Docker、Web 服務或殘留進程佔用;若日誌為空,果斷重啟排查。